双 2080Ti 魔改卡跑 Qwen3.8-Flash-Next 125B:两天调优实录,从 40 到 100 t/s
本文最后更新于 2026年11月16日 中午
先说结论
两天,两台机器,四轮换档,十几次配置实验,我们把 Qwen3.8-Flash-Next(125B MoE)在双 RTX 2080Ti 22G 魔改卡上从 40 t/s 调到了 100 t/s(另一台双 3080 机器同样到 100+)。这篇是完整的踩坑实录,所有数字都来自暖态三轮中位实测,所有结论都可复现。
最终配置一句话:Strata 引擎 + IQ3_XXS 量化 + 256k 上下文 + 纯 MTP 推测解码。
为什么是 Strata:125B MoE 怎么塞进 44G 显存
Qwen3.8-Flash-Next 是 125B 参数的 MoE 模型,总权重远超两张 22G 显存卡能装下的量。三条路线里只有一条能走:
| 方案 | 结论 | 原因 |
|---|---|---|
| llama.cpp | ❌ | qwen4exp 架构只支持 layer split(tensor split 报 not implemented),MTP 原生缺位 |
| NInfer | ❌ | 仅支持 RTX 5090(sm_120a),构建期 arch 检查直接拒绝 |
| Strata | ✅ | 原生 MTP + 专家从 RAM 按需流式到显存,双卡 layer split 不需要 NVLink |
核心机制是专家流式:MoE 的专家权重常驻系统内存(图灵机 121G RAM),每次前向只把被激活的专家经 PCIe 拉进显存的热点缓存。显存不够没关系,RAM 来凑——这就是老卡跑大 MoE 的门票。
第一个坑:dflash2 推测解码器拖速 30%+
部署初期速度只有 40-53 t/s,怎么调都上不去。翻引擎日志才发现:安装器默认注入的 dflash2 drafter 显存占了 +1026 MiB,但 serve 模式下 drafts accepted 恒为 0 of 0——一个 draft 都没被接受,纯粹的显存和调度开销。
更隐蔽的是,dflash2 在位时会把真正有效的 MTP(Multi-Token Prediction,模型自带的推测头)挤掉。删掉 dflash2 三件套参数(--draft dflash2 --draft-model ... --draft-fallback none)之后:
| 机器 | 删前 | 删后 | 提升 |
|---|---|---|---|
| 安培(双 3080) | 59 t/s | 82 t/s | +39% |
| 图灵(双 2080Ti 魔改) | 40 t/s | 53.6 t/s | +34% |
一个”无效组件把有效组件挤掉”的案例。教训:推测解码的收益要看 drafts accepted 计数,不是配了就赚。
四档量化实测:速度与体积严格反比
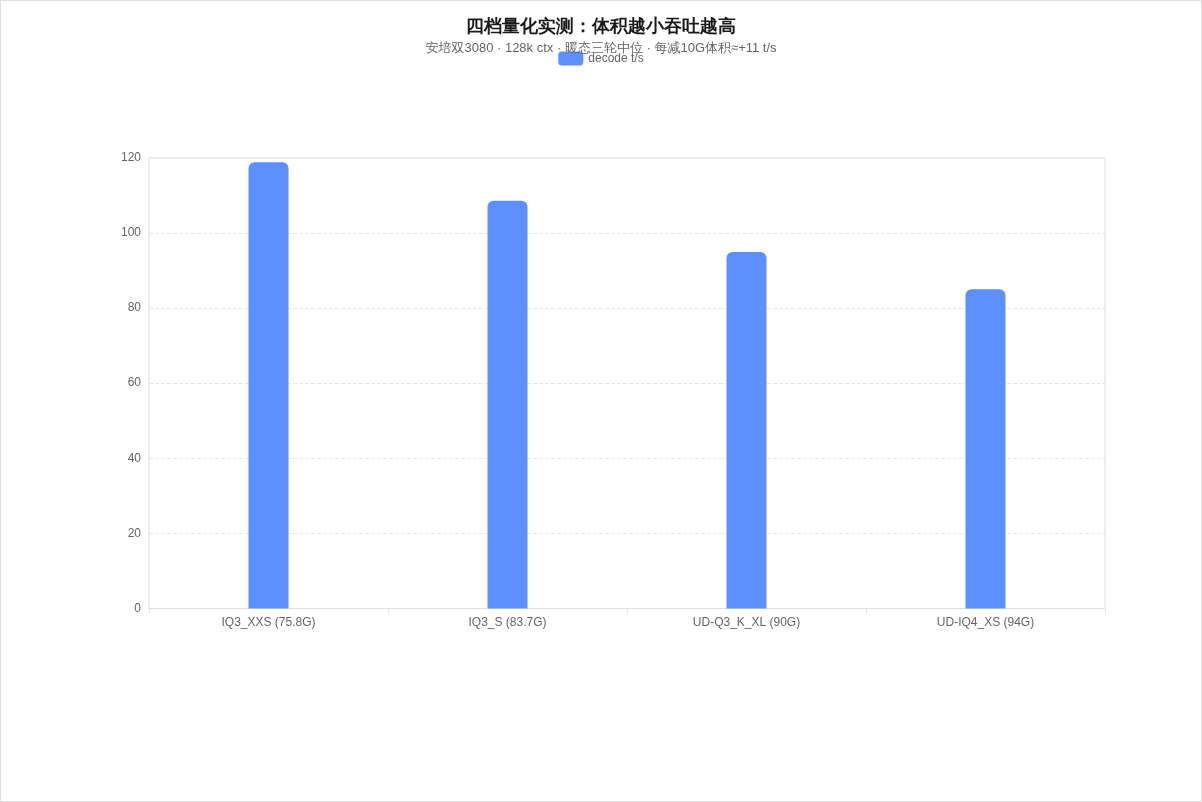
同样硬件(安培双 3080)、同样 128k 上下文、同样纯 MTP,只换量化档:
| 量化档 | 体积 | decode 中位 | MTP 接受率 |
|---|---|---|---|
| IQ3_XXS | 75.8G | 118.8 t/s | 61% |
| IQ3_S | 83.7G | 108.6 t/s | 62.5% |
| UD-Q3_K_XL | 90G | 94.9 t/s | 62% |
| UD-IQ4_XS | 94G | 85 t/s | ~63% |
三个发现:
- 斜率约每 10G 体积换 11 t/s。因为瓶颈在 PCIe 专家流:专家字节少 10%,同样带宽能拉多 10% 的专家。
- MTP 接受率四档几乎不变(61-63%)。量化影响的是单 token 计算速度,MTP 靠的是模型自身的冗余性,两者正交。
- 质量三题(常识问答)四档全对——太浅的测试分不出质量档位,真实质量差距要靠长文写作和代码任务才能显现。日常用途选最轻的 IQ3_XXS,质量敏感场景再上 4-bit。
上下文 256k 的代价,取决于你用多重的量化
这轮实验推翻了我们自己一天前的结论。
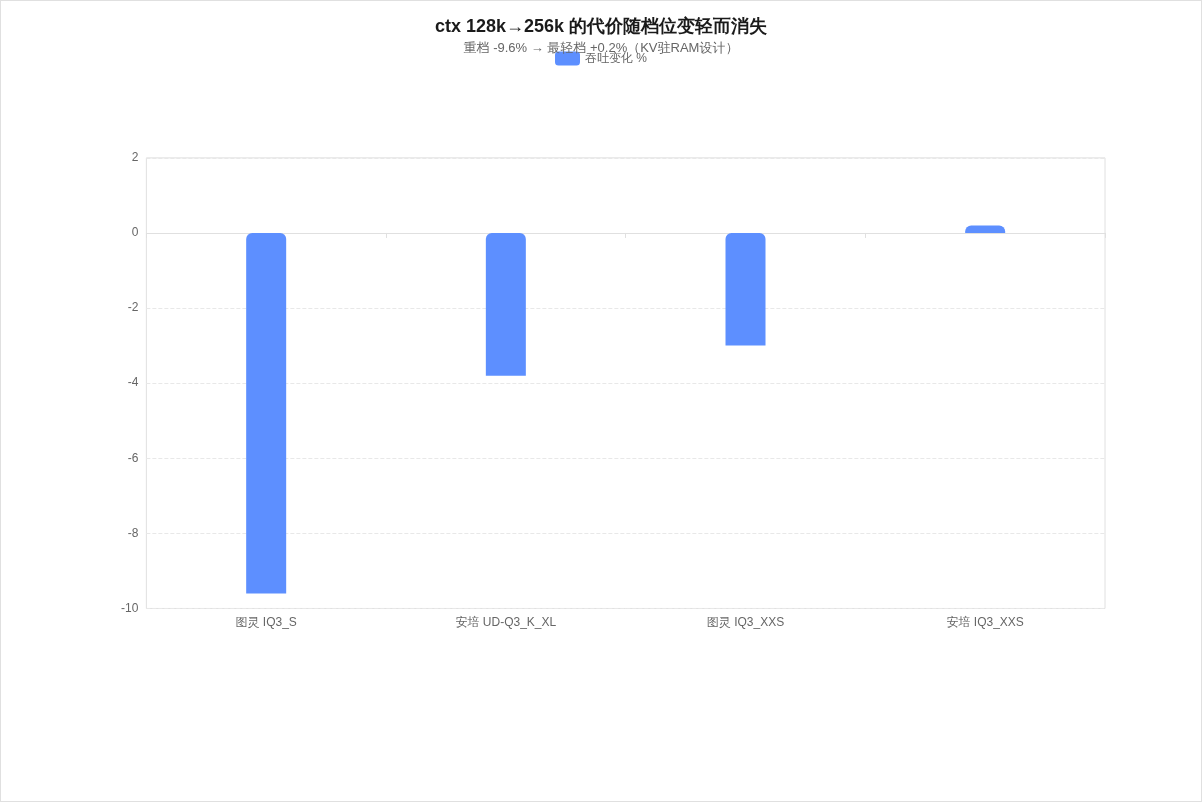
11-16 凌晨测得”256k 比 128k 慢”(图灵 IQ3_S:74.9→67.7,-9.6%),于是定为 128k。中午在安培 IQ3_XXS 上复测:100.2→100.4,零代价。
| 档位 | 128k | 256k | 代价 |
|---|---|---|---|
| 图灵 IQ3_S | 74.9 | 67.7 | -9.6% |
| 安培 UD-Q3_K_XL | 96.3 | 92.8 | -3.8% |
| 安培 IQ3_XXS | 100.2 | 100.4 | ≈0 |
| 图灵 IQ3_XXS | 55.8 | 54.1 | ≈-3%(噪声级) |
规律清晰:量化越轻,上下文代价越小。机制是 KV streaming——KV 缓存的最近 32768 cells 驻显存(固定窗口,不随 ctx 缩放),完整 K/V 镜像驻 pinned RAM。ctx 翻倍 → KV 换页流量翻倍;但轻档的专家流本来就占满了 PCIe,KV 换页占比相对小。
代价去哪了?显存不变,内存线性涨。实测安培 128k→256k:
| 项 | 128k | 256k |
|---|---|---|
| 显存 | 38.5G | 38.6G |
| KV pinned RAM | 0.64 GiB | 1.29 GiB(翻倍) |
| 引擎 RSS | ~49.4G | 50.0G |
每 +128k ctx ≈ +0.65G pinned RAM(int8 KV)。显存稳定的原因是 --kv-resident 32768 固定驻留窗口。所以”上下文要不要开大”这个问题,先看你的 RAM 余量,不是显存。
显存预算:–vram-reserve-mib 是唯一正确旋钮
图灵机还要腾显存给语音识别/合成。需求:Strata 显存从 42.6G 压到 32G。
专家缓存的 auto 模式默认”吃满剩余显存换命中率”(99.5% 命中,78% 的 decode 计算走显存缓存)。压缩它有两条看似可行的路,实测都是坑:
--expert-cache-device1:直接崩溃。与 layer split 冲突,engine exit 2,systemd 陷入重启循环。- 固定
--expert-cache N:只约束 CUDA0,第二张卡照样自动填满(所谓”两卡不对称”问题的真因)。
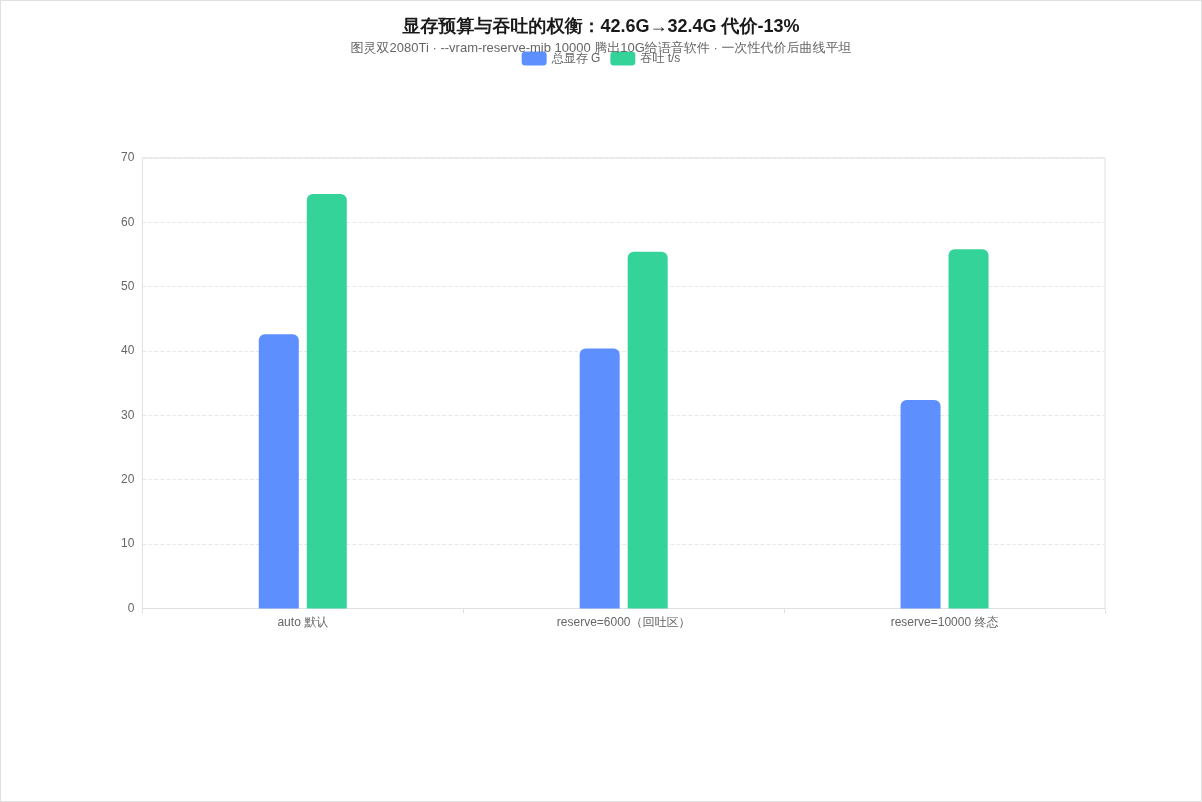
正确旋钮是 --vram-reserve-mib(默认 700):auto 缓存的公式是”空闲显存 - reserve = 缓存槽”,把 reserve 调大,auto 自然少吃。实测曲线:
| 配置 | 总显存 | 吞吐 | 命中率 |
|---|---|---|---|
| auto(默认) | 42.6G | 64.4 t/s | 99.5% |
| reserve=6000 | 40.4G | 55.4 t/s | 98.4% |
| reserve=10000(终态) | 32.4G | 55.8 t/s | 96.6% |
有个中间陷阱:reserve=6000 时缓存槽缩到阈值以下,引擎的 prompt path 从”借缓存槽”切换成”独立分配 4.12G/卡 缓冲”(日志:keeps its own prompt buffers: no loan),把你释放的显存又吃回去大半——净释放只有 2.2G/卡。直接把 reserve 拉过这个阈值(10000)就跨过去了。
最终 -13% 吞吐换 10.2G 显存,每卡留出 ~6.3G 给 whisper-large + TTS,够用。
那些不直观但重要的细节
采样参数不用配。Strata server 内置了各架构官方推荐(Qwen3.8 thinking 模式:temp 1.0 / top_p 0.95 / top_k 20),不写采样配置就是最优,客户端手动设置反而会覆盖掉推荐值。
profile 有两份 args。改配置必须同步改 args 和 args_written 两份,改一漏一会出现”看起来改了但没生效”的灵异问题。
server 层参数会延迟爆炸。--parallel/--batch-mtp 是 server 层参数,engine 不认。带它们改 ctx 时 vram_fit 走另一分支,参数原样透传 engine → unknown argument → 崩溃循环。131k 下正常、256k 下爆炸,延迟发作极难排查。
换档 = 手工补丁全丢。从 install json 重新生成的 profile 不带任何历史修复(工具调用修复、ctx、调优参数)。每次换档用一站式模板脚本生成,别手工拼。
磁盘要预留。换档前先 df -h:图灵机装 IQ3_XXS 时就因为剩 64G < 需 76G 装到一半失败,删掉旧档才装上。
终态配置
两台机器最终对齐为完全相同的配置:
1 | |
| 机器 | 硬件 | decode | 显存 | RSS |
|---|---|---|---|---|
| 安培 | 双 3080 20G 魔改 + 92G RAM | 100.4 t/s | 38.6G | 50G |
| 图灵 | 双 2080Ti 22G 魔改 + 121G RAM | 54.1 t/s | 32.6G | 73.3G |
从 40 t/s 到 100 t/s,2.5 倍的提升没有花一分钱硬件,全部来自:删掉无效组件(+34%)、选对量化档(+28%)、上下文与显存的正确取舍。老卡跑新模型,值得。
(完)